Ensinei o Claude Code a documentar minha sprint no ClickUp (e ele abriu a última task sozinho)
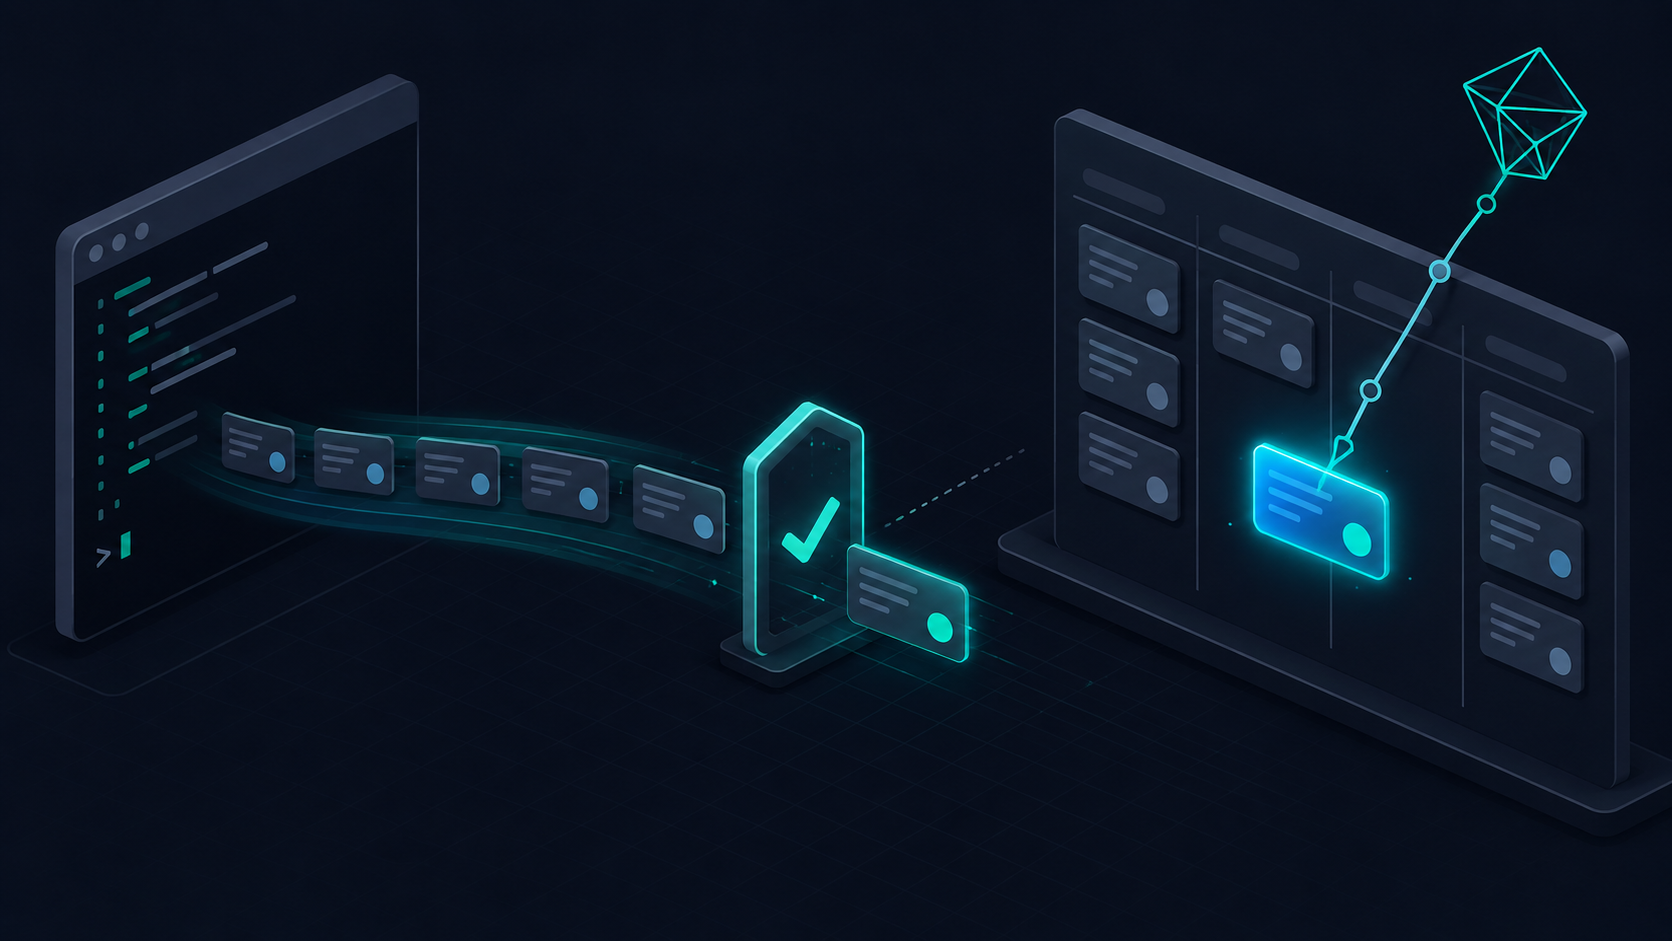
Da conversa pro board: a skill propõe as tasks pontuadas, eu aprovo, ela escreve.
Numa única conversa com o Claude Code saíram 15 tasks pontuadas, 11 subtasks reestimadas e dois pull requests. Eu não abri o ClickUp em momento nenhum. No fim, a parte que mais me marcou foi banal: a própria ferramenta que eu tinha acabado de construir criou a última task do board, sozinha, fechando o loop.
Esse post é a história de como cheguei nisso e, principalmente, o que eu encontrei quando fui abrir a implementação pra escrever aqui. Não é um tutorial de como criar uma skill do zero. Esse eu já contei no post do /save-session. Aqui o assunto é o que acontece quando você dá a uma skill o poder de escrever num sistema que o time inteiro usa, e o que essa escrita pode quebrar quando ela falha no meio.
Por que o board ficava pra trás
Trabalho de infraestrutura quase sempre acontece antes da burocracia. Você investiga um custo, mexe num cluster, prepara um upgrade de banco, e só depois lembra que aquilo precisa virar registro em algum lugar. O registro fica pra trás. A sprint não reflete o que foi feito. O esforço some.
Abrir task no meio do trabalho dá preguiça porque dá trabalho de verdade: título, escopo, pontos, épico, sprint certa, atribuição. Multiplica por quinze e ninguém faz. Foi exatamente o que aconteceu comigo numa sessão de trabalho de custo: eu tinha um monte de coisa feita e planejada, e zero disso no board.
A virada foi parar de tratar a documentação como uma segunda jornada e passar a tratar como subproduto. Eu conversei com o Claude Code enquanto fazia o trabalho de verdade, e no fim pedi pra ele documentar.
Do curl improvisado pra uma skill
Não comecei com uma skill. Comecei com a coisa mais burra que funcionava: pedi pro Claude descobrir como a gente já falava com o ClickUp. Ele varreu o código, achou uma integração existente que abre task automaticamente quando o robô diário de custo AWS detecta anomalia, entendeu o padrão da API e passou a montar chamadas a partir dali. Em poucos minutos eu tinha tasks sendo criadas via curl improvisado.
Funcionou, e era frágil pelo motivo mais chato: a cada novo pedido o modelo redescobria os mesmos IDs, os mesmos campos, a mesma convenção. Redescoberta é onde mora a variação, e variação em escrita é onde mora o erro. Empacotei numa skill do Claude Code, que é um diretório com um SKILL.md que carrega só quando é usado:
~/.claude/skills/clickup-ops/
├── SKILL.md        # instrucao pro modelo: quando usar, fluxo, regras combinadas
├── reference.md    # ids estaveis do workspace e mapeamento dos custom fields
└── scripts/cu.py   # o que fala com a API, sem modelo no meio do caminho
O SKILL.md tem frontmatter com name e description, e é a description que faz o modelo puxar a skill quando eu falo de sprint, ponto ou task. O corpo dele não é código: é o combinado com o time escrito em português, e cada regra dali vira uma das seções abaixo.
O reference.md guarda o que é estável e caro de descobrir: ids de workspace, space e folder de sprints, o meu user id, e o mapeamento dos custom fields com o UUID de cada opção. Tem uma linha ali que vale mais que o resto do arquivo: as list ids de sprint não são estáveis, mudam a cada quinzena, e por isso são proibidas de virar constante.
O cu.py é o único que toca a rede, e nenhum subcomando dele pede opinião. A regra que eu segui é simples de enunciar e chata de manter: o modelo decide o quê, o script decide como. Escolher o ponto de uma feature é julgamento. Montar payload, resolver UUID de opção e escolher endpoint é determinístico, e determinístico não se delega pra um gerador de texto.
De “documenta isso” até a task criada
O pedido chega em linguagem natural, do tipo “abre essas tasks na sprint”. A primeira coisa que a skill faz é descobrir a sprint corrente, e o método é mais rústico do que eu gostaria: ela lista o folder de sprints, extrai as datas do nome de cada lista com regex e escolhe a que contém hoje. Quando nenhuma cobre o dia, ela não chuta, avisa e manda usar o backlog ou uma lista explícita. Depende de convenção de nomenclatura e quebra se alguém renomear uma sprint. Aceito o acoplamento porque a alternativa, cravar id, quebra a cada quinze dias em silêncio.
Resolvida a lista, o resto sai do reference.md: épico, tipo, responsável e o UUID da opção de ponto. Aí ela monta o plano e me mostra antes de escrever qualquer coisa:
Sprint 25/08 a 05/09  (lista 9011xxxxxx)

  5 pts  Infra     Tecnica  Corrigir alarme que nao dispara em fila parada
  3 pts  Cronjobs  Tecnica  Migrar job diario de custo pro agendador novo
  2 pts  Infra     Debito   Remover credencial de servico do script legado

  3 tasks | 10 pts | status todo
Eu aprovo ou ajusto, e só então ela sobe. Depois da escrita, imprime o id e a URL de cada task, que é o que a resposta da API devolve. Não há releitura pra conferir se o board ficou como o plano dizia.
Os dois campos de ponto, e o que eu errei na primeira implementação
O ClickUp tem dois lugares diferentes pra guardar ponto, e eles não conversam. Tem o custom field que o time configurou no board, um dropdown, e tem o Sprint Points nativo, que é o que alimenta o relatório de velocity. Preencher só um deixa o board mostrando um número e o relatório contando outro.
A skill escreve nos dois, sempre iguais. A parte que eu errei foi como.
Eu implementei a criação em duas etapas: o POST criava a task já com o custom field, e um PUT posterior preenchia o Sprint Points. Ao revisar a implementação pra escrever este texto, descobri que a separação não era necessária na criação. O endpoint de criação aceita points e custom_fields no mesmo payload:
POST /api/v2/list/{list_id}/task
{
  "name": "Corrigir alarme que nao dispara em fila parada",
  "description": "Escopo da task.\n\n---\nPS: task aberta automaticamente pelo Claude Code.",
  "status": "todo",
  "assignees": [<user_id>],
  "points": 5,
  "custom_fields": [
    {"id": "<uuid do campo Pontos>", "value": "<uuid da opcao 5>"},
    {"id": "<uuid do campo Epic>",   "value": "<uuid da opcao Infra>"}
  ]
}
A separação em duas chamadas só é obrigatória em outro caso, o de repontuar uma task que já existe. O endpoint de atualização aceita points, mas não aceita custom_fields, e a documentação é explícita ao dizer que pra atualizar Custom Fields você precisa usar o endpoint específico:
POST /api/v2/task/{task_id}/field/{field_id_pontos}   {"value": "<uuid da opcao 8>"}
PUT  /api/v2/task/{task_id}                           {"points": 8}
São quatro casos, e eu perdi tempo por não ter isso escrito em lugar nenhum. Criar task com ponto é uma chamada só. Atualizar o campo nativo de uma task existente é PUT com points. Atualizar o custom field é POST no endpoint de custom field. E manter os dois em sincronia numa task existente é obrigatoriamente duas chamadas.
Tem uma armadilha a mais no dropdown, e ela vale nos dois sentidos. Ao escrever, o campo não aceita o número 5, aceita o UUID da opção que vale 5. Ao ler, ele devolve orderindex, e a ordem configurada no meu board não é a ordem numérica: o índice 1 é o ponto 3 e o índice 2 é o ponto 2. Quem lê uma task e reescreve confiando no índice troca 3 por 2 sem receber erro nenhum. A única fonte confiável é o mapeamento entre o UUID canônico e o valor semântico, que é exatamente o que o reference.md existe pra guardar.
O default 8
Essa é a parte em que a IA quase me passou a perna sem querer.
Eu tinha um conjunto de subtasks pra pontuar, e o campo já vinha preenchido: todas com 8. Olhei e o número não cheirava bem, porque 8 é o teto da escala do board, que vai de 1 a 8 e não tem 13. Teto em tudo, do item mais trivial da lista, um fallback de valor padrão, até o mais pesado, um fluxo conversacional de várias etapas. Isso não é estimativa. É o padrão clássico de quem aplicou um valor em lote e seguiu a vida.
Se eu tivesse pedido pro Claude só copiar o que já estava lá, ele teria propagado aquilo com a maior cara de competência, e sem cometer erro nenhum de execução. Aqui mora a distinção que eu não sabia formular antes desse dia: transportar uma estimativa e produzir uma estimativa são operações diferentes. Transportar é mecânico e a máquina faz melhor que eu. Produzir exige comparar o item com outros que já foram entregues, e essa é justamente a evidência que falta pro modelo: ele lê o título, o escopo dito na conversa e o que apareceu no código durante a sessão, mas não tem o histórico de quanto doeu a última feature parecida.
Pedi pra reestimar item a item e o resultado saiu variado, de 2 a 8, somando bem menos que o bloco de oito em tudo. A regra que ficou pra skill é declarar contexto insuficiente em vez de arriscar quando o escopo não apareceu na conversa. A que ficou pra mim é mais curta: ferramenta nenhuma substitui o seu julgamento sobre o tamanho das coisas. Ela acelera o registro, não a decisão.
O que pode dar errado no meio da escrita
Volte na criação em duas etapas. O POST cria a task e já grava o custom field de ponto. Se o PUT seguinte falhar, por rede, por 429, por um 500 do outro lado, o script morre ali. E o que fica pra trás é isto: a task existe, o board mostra o ponto no campo do time, e o Sprint Points nativo está vazio. A velocity passa a divergir do número que aparece na tela.
Ou seja, o modo de falha da minha implementação produzia exatamente a inconsistência que ela existia pra evitar. E o pior detalhe é que ela falha em silêncio do ponto de vista do board: ninguém recebe erro, ninguém vê task pela metade, só um número que não bate daqui a uma semana.
A correção de fundo é a chamada única que a API já permitia, porque ela elimina a janela entre os dois estados. Onde a janela é inevitável, no caso de repontuar task existente, o certo é ler de volta e comparar antes de dizer que deu certo.
O fallback que troca a sua identidade
O token nunca esteve no repositório nem no arquivo da skill, e nisso eu não abri mão. Quando o próprio modelo sugeriu, em algum momento, salvar o token num arquivo pra facilitar, eu recusei. Credencial em texto puro versionada é dívida que volta pra te morder, e construir ferramenta nova não é desculpa pra repetir o erro que a gente passa a vida pedindo pros outros não cometerem.
O que eu não tinha percebido é mais sutil, e não é sobre onde o segredo mora. É sobre qual identidade ele carrega.
O script lê $CLICKUP_TOKEN do ambiente e, se não achar, cai num secret no AWS Secrets Manager. Em shell interativo, a variável aponta pro meu token pessoal. Em shell não interativo a coisa muda: o ~/.bashrc tem o guard clássico que retorna cedo quando não há sessão interativa, o export nunca acontece, a variável chega vazia, e o script cai no fallback sem reclamar. O segredo que ele recupera pertence a uma conta de serviço, não a mim. A operação funciona, a task é criada, e a autoria registrada muda.
O problema não é o Secrets Manager, que é exatamente o lugar certo pra guardar isso. O problema é um fallback silencioso trocar o principal da operação. O que eu quero é que a origem da credencial apareça, que a identidade escolhida seja registrada antes da escrita, e que a execução falhe quando a identidade esperada não estiver disponível, em vez de trocar de principal por conta própria.
O engraçado é que a skill já faz isso certo em outro lugar. O comando que cria documento recusa o fallback e exige uma flag explícita pra usar a conta de serviço, porque ali a consequência é visível na hora, o documento nasce com dono errado. Na criação de task a consequência é invisível, e por isso a proteção não foi escrita. Consequência invisível é onde a gente esquece de se proteger.
Quem aprovou, quem executou, quem assina
O passo de confirmação antes de escrever em lote não é cosmético. Não é “você tem certeza?”, que ninguém lê depois da terceira vez. O que aparece na tela é o plano inteiro, com alvo, ponto e épico de cada item, e é a última chance de pegar a lista certa na sprint errada, que é o erro caro e chato de desfazer.
Junto veio a marcação de procedência: toda task aberta pela skill leva no fim da descrição um PS dizendo que foi aberta automaticamente pelo Claude Code. Ela tem dois defeitos que eu já enxergo. É prosa na descrição e não campo estruturado, então não dá pra filtrar nem contar por ela num relatório, e marcador de procedência devia ser campo num board que tem campos. E texto igual repetido em toda task vira ruído, porque o leitor para de enxergar depois da décima.
O que essa marcação registra, no fim, é só uma das três coisas que a gente costuma confundir numa frase só. Quem executou é o que o PS diz. Sob qual identidade é o que o token define, e é o que o fallback silencioso pode mentir. Quem respondeu pela decisão sou eu, sempre, porque fui eu que aprovei o plano. Automação que embaralha as três produz um board onde ninguém sabe a quem perguntar.
O loop que fechou sozinho
No fim daquela sessão, investigando algumas tasks, apareceu uma ação residual que não estava no board. Pedi pra registrar. A skill, agora pronta, criou a task. Foi a primeira vez que ela rodou a partir de uma decisão tomada na própria conversa, em vez de um comando meu explícito de “cria task tal”. Pequeno, mas foi o sinal de que a ferramenta tinha deixado de ser experimento e virado parte do fluxo.
Os controles que eu adicionaria hoje
Nada do que está aqui existe na implementação. Estou escrevendo como dívida, não como recurso.
Não há timeout explícito nas chamadas HTTP, então uma conexão pendurada trava a execução até o sistema operacional desistir. Não há retry nem backoff. O 429 não é tratado, cai no mesmo caminho de erro genérico de qualquer outro status. Não há idempotência nem deduplicação: rodar o mesmo lote duas vezes cria o dobro de tasks, e o único guarda-corpo é a minha atenção na hora de aprovar. Não há dry-run de verdade, e não há verificação depois da escrita.
Sobre o 429, vale fazer a conta em vez de dar de ombros. O limite oficial no plano Business é de 100 requisições por minuto por token, com os headers X-RateLimit-Limit, X-RateLimit-Remaining e X-RateLimit-Reset na resposta. Aquelas 15 tasks a duas chamadas dão cerca de 30 requisições, bem abaixo do teto. Só que o limite é por token, e esse mesmo token é usado pelo robô de custo que roda toda manhã, então as duas automações competem pela mesma cota. Um lote maior, ou dois ao mesmo tempo, chegam lá sem esforço.
O formato que eu quero é este:
plano aprovado
  -> --dry-run: imprime o payload final de cada task e nao chama a API
  -> escrita: um POST por task, com points e custom_fields no mesmo corpo
  -> 429 ou 5xx: respeita X-RateLimit-Reset, tenta de novo, e desiste com o indice do lote
  -> verificacao: GET /task/{id} e compara points e custom field com o plano
  -> divergiu: reporta a task pelo id e diz qual campo ficou pra tras
O que essa sequência entrega não é robustez genérica. É a capacidade de responder uma pergunta específica depois de uma execução interrompida: quais itens do plano ficaram no board, quais não, e quais ficaram pela metade. Hoje a resposta é abrir o ClickUp e olhar.
O que fica
O ganho de tempo é real. Construir a skill custou menos que documentar uma sprint cheia na mão, e ela paga esse custo toda vez que eu abro um board agora. Mas o que ficou mais valioso não foi ficar mais rápido, foi ficar mais correto: os dois campos de ponto sempre iguais, o épico sempre preenchido, a sprint sempre a corrente. Registro feito na mão às onze da noite erra mais que isso.
O resto é sobre a natureza da revisão. Quando uma IA só lê e responde, um erro dela é um parágrafo errado. Quando ela escreve num sistema que o time usa, um erro vira ruído no board, número torto na velocity e decisão tomada em cima de dado falso. E o erro que eu achei aqui não foi nem do modelo: foi meu, escondido atrás de uma sequência de chamadas que funcionava em todos os dias normais. Ferramenta que escreve no mundo externo merece a mesma revisão que código de produção, e o teste de que ela está pronta não é ela funcionar. É você saber dizer o que sobra quando ela falha no meio.